女装AI视频反复翻车,核心往往不是提示词写得不够花哨,而是画面变量没有被系统固定。想要稳定产出可商用的展示素材,可以延伸学习 StableDiffusion AI作图进阶课程,其中涵盖ControlNet画面控制、图生图与高清放大等关键技法,并附带服装设计、电商等多行业商用实战案例,正好对应服装展示场景对人物与商品画面一致性的严格要求。
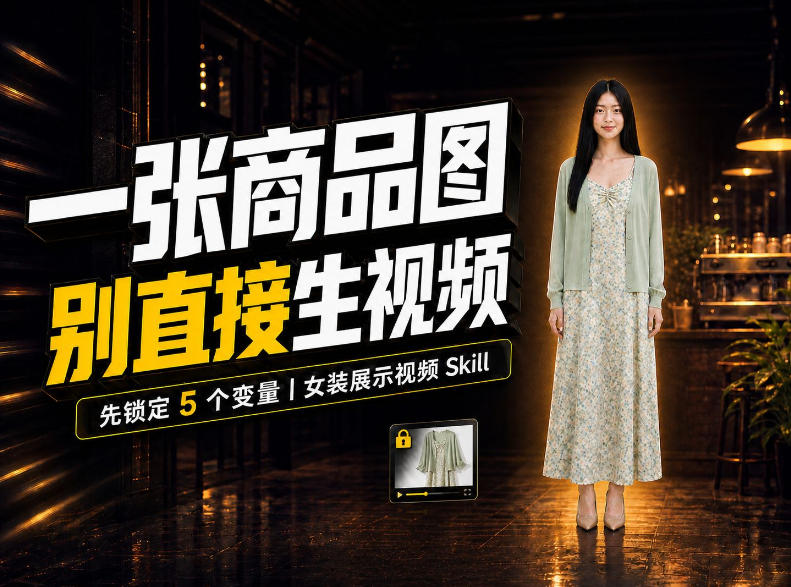
女装AI视频总翻车?问题不在提示词,女装展示视频Skill先锁定5个变量!Skill说明1.Skill的作用将女装商品图、动作参考视频和Amazon商品展示上下文组织为可执行的视频生成包,稳定产出已确认主视觉、动作时间线、参考图映射、提示词、平台接力清单与成片验收标准。2.使用前需要准备什么准备清晰的女装商品图、可播放的动作参考视频,以及平台、站点、商品类目和展示位置。当前已确认上下文为Amazon.com、Women’s Dresses、Listing商品视频。3.它会怎么工作先核验素材与平台上下文,再确认模特基准、换装主视觉和动作时间线;随后生成双语时间线、视频提示词、负面约束、参考图槽位映射和平台操作清单,最后按成片验收标准归档交付。4.两种使用模式快速生成模式。在商品图、动作视频和平台上下文完整时,完成关键映射后直接形成可提交内容生成平台的视频包。标准确认模式。依次确认素材映射、主视觉和动作时间线,再生成完整交接包;适用于对服装一致性、人物连续性和平台展示要求更高的商品视频。5.一定要强调的边界动作参考仅继承动作、表情与镜头节奏,不继承原视频的人物、服装或场景。商品图中的服装细节必须保持一致。用户自行登录内容生成平台、完成生成、付费、上传和发布;平台实际审核结果以提交页面为准。*提示本文仅为介绍,不构成任何收益承诺,变现效果因人而异,需结合自身努力与实操,合理运用所学内容,同时严格遵守平台相关规则与相关法律法规*
这套Skill到底管什么
先把定位说清楚:它不是直接帮你生成视频的工具,而是把三样东西女装商品图、动作参考视频、Amazon展示上下文整理成一个可以直接交给内容生成平台的视频包。产出物包括已确认的主视觉、动作时间线、参考图映射、提示词、负面约束、平台接力清单和成片验收标准。生成、付费、上传、发布这些动作,仍然要你自己在平台上完成。
标题里的5个变量指什么
对照正文的流程,Skill要求先落定的其实是这么几项:素材核验结果、平台上下文(站点、类目、展示位置)、模特基准、换装主视觉、动作时间线。后面生成的双语时间线、提示词、参考图槽位映射,都是从这几项推出来的。
很多翻车情况不是提示词写得不好,而是这几项里有一项含糊:比如动作时间线还没确认就开始写提示词,或者商品图和动作参考视频的对应关系没锁死,出来的成片里人物换了一套衣服、动作对不上节奏。所以顺序上一般是先把变量定下来,再让提示词去描述已经确定的东西。
两种模式怎么选
- 快速生成模式:商品图、动作视频、平台上下文三样都齐的时候用。完成关键映射后直接形成可提交的视频包,路径短,适合先跑通一遍流程、看看整体产出长什么样。
- 标准确认模式:按顺序依次确认素材映射、主视觉、动作时间线,再生成完整交接包。适用于对服装一致性、人物连续性、平台展示位置要求更高的商品。
常见做法是先用快速模式熟悉输出结构,遇到对一致性要求高的款,再切到标准确认模式逐项过一遍,而不是一开始就上最重的流程。
使用前把素材备齐
需要三类输入:清晰的女装商品图、可播放的动作参考视频,以及明确的平台、站点、商品类目和展示位置。当前已确认的上下文是Amazon.com、Women's Dresses、Listing商品视频。实际操作时,一是容易漏掉最后一项展示位置没写清楚,后面平台接力清单就无从对齐;二是视频给的是损坏文件,核验环节直接卡住。
必须记住的边界
这条最容易被忽略:动作参考视频只继承动作、表情和镜头节奏,不继承原视频里的人物、服装和场景。也就是说,原视频里的模特长相、她穿的衣服、拍摄背景都不会带过来。同时,商品图中的服装细节必须保持一致版型、花色、领口袖口这些是验收时的重点。
平台的实际审核结果以提交页面为准,不要把本地预览当成最终结果。涉及收益的部分,原文也写明了不构成任何承诺,效果因人而异,需结合自身实操并遵守平台规则与相关法律法规。
归档这一步别省
最后一步是按成片验收标准归档交付。这一步看着像收尾工作,但同一个商品后续换款、换展示位置时,有归档记录能直接对照上次的映射关系和时间线,比重新核一遍素材省事。
网创项目资源网,网络副业项目发布平台,如若转载,请注明出处:https://123how.com/82091.html